Les 12 erreurs qui coûtent le plus cher aux débutants, dont celle qui fait fondre ta limite sans bruit. Toutes viennent de sessions réelles.
Erreur 1, ne pas créer de CLAUDE.md
Ce qui se passe : chaque session repart de zéro. Un jour les fichiers vont dans src/components/, le lendemain ailleurs, et les règles métier que tu as expliquées hier ont disparu.
Ce qu'il faut faire : crée le CLAUDE.md dès la première heure du projet (voir chapitre 3). Tu arrêtes de répéter tes conventions à chaque session.
Signe d'alerte : si tu te retrouves à répéter "utilise la palette du
projet" ou "les fichiers vont dans src/components/", ton CLAUDE.md est
incomplet.
Erreur 2, demander tout d'un coup
"Construis-moi une app complète de gestion de projets avec auth, dashboard, facturation, analytics, et un assistant IA" : Claude va le faire, mais en surface, avec des raccourcis partout et un code que personne ne pourra maintenir. Découpe plutôt en features, une à la fois, avec un plan pour chacune. Tu ne passes à la suivante qu'une fois la précédente livrée, testée et commitée.
Règle : si ta demande contient plus de 3 "et", elle est trop grosse. Découpe.
Erreur 3, foncer sans planifier
Ce qui se passe : Claude fait des choix techniques sans te consulter. Tu découvres après 30 minutes de code qu'il a pris la mauvaise approche. Tout est à refaire.
Ce qu'il faut faire : 10 minutes de brainstorm + plan évitent 2 heures de retravail. Voir chapitre 5.
Exception : les bug fixes simples et les ajustements cosmétiques n'ont pas besoin de plan.
Erreur 4, accepter aveuglément le résultat
Ce qui se passe : Claude peut faire des erreurs subtiles : une condition inversée, un cas limite non géré, un problème de sécurité. Sans test, ces bugs arrivent en production.
Ce qu'il faut faire : teste toujours visuellement sur localhost. Toi seul sais si l'UX correspond à ta vision. Claude ne voit pas ton écran.
Vérifie au minimum :
- Le comportement normal fonctionne
- Les cas d'erreur sont gérés (mauvaise saisie, données vides)
- Le responsive (mobile) fonctionne
- Les textes sont corrects (accents, grammaire)
Erreur 5, ne pas itérer
Le premier jet "qui marche" est rarement celui que tu veux montrer à tes utilisateurs. Il pose la structure, et c'est tout. Deux ou trois allers-retours ciblés suffisent en général pour passer à un résultat propre, par exemple :
- "Augmente l'espacement, c'est trop tassé"
- "Ajoute une animation quand les données se chargent"
- "Le message d'erreur est trop technique, reformule-le pour un non-développeur"
Erreur 6, sauter les vérifications
Ce qui se passe : tu accumules des erreurs invisibles qui explosent plus tard. Un type incorrect ici, un import cassé là, et soudain ton build ne compile plus avec 47 erreurs.
Ce qu'il faut faire : lance typecheck + lint après chaque modification. Non négociable. Une erreur attrapée tout de suite se corrige en une ligne.
Astuce : en auto mode, ou avec une allowlist bien configurée (voir le chapitre 9), Claude lance ces vérifications sans te demander.
Erreur 7, écrire des prompts vagues
Un prompt vague donne un résultat au hasard, et tu enchaînes 3 ou 4 allers-retours pour obtenir ce que tu avais en tête. La recette du chapitre 4 tient en une ligne : contexte + quoi + critères + contraintes. 30 secondes de formulation économisent 10 minutes de corrections.
Erreur 8, ne pas sauvegarder la mémoire
Le lendemain, Claude te repropose l'approche que tu as écartée la veille et refait une erreur déjà corrigée. L'auto memory est active par défaut, mais elle ne retient pas tout. En fin de session productive, dis "Mets à jour la mémoire projet.", et passe de temps en temps dans /memory pour corriger ce qui est faux. Détails au chapitre 10.
Erreur 9, tout faire en séquence
Ce qui se passe : tu perds du temps en attendant que chaque tâche finisse alors que certaines pourraient tourner en parallèle.
Ce qu'il faut faire : identifie les tâches indépendantes et dis-le explicitement.
"Lance en parallèle : la migration SQL, le composant UI, et les tests unitaires. Ces 3 tâches sont indépendantes."
Claude lance 3 subagents en arrière-plan au lieu de faire l'un après l'autre. Tu gagnes du temps, mais ta consommation ne baisse pas : chaque subagent repart de son propre contexte, sans le cache de ta conversation (voir le chapitre 7).
Quand ne pas paralléliser : quand une tâche dépend du résultat d'une autre (ex : les types TypeScript dépendent de la migration SQL).
Erreur 10, ignorer la gestion du contexte
Ce qui se passe : tu enchaînes trois features dans la même conversation. Le contexte (tout ce que Claude a en mémoire de travail pour cette conversation) se remplit de fichiers lus, de logs, de pistes abandonnées. Claude commence à oublier tes conventions et à refaire des erreurs déjà corrigées. Tu perds 20 minutes avant de comprendre que le problème vient du contexte.
Ce qu'il faut faire : surveille le contexte (via /context ou la status line). /compact à la fin d'une phase de travail, /clear si tu changes de sujet (c'est gratuit). Et si Claude part en vrille, /rewind (Esc Esc) plutôt que d'essayer de corriger dans le même contexte pollué. Les modèles actuels ont 1 million de tokens de contexte. Claude commence pourtant à dériver souvent bien avant cette limite.
Signe d'alerte : Claude commence à "oublier" des règles qu'il respectait en début de session. C'est le signal qu'il faut compacter.
Erreur 11, ne jamais faire de /code-review
Ce qui se passe : le code tourne, donc tu commites. Sans review tu laisses passer des failles de sécurité (données utilisateur exposées), des cas limites non gérés (que se passe-t-il si la liste est vide ?), du code mort qui alourdit l'app.
Ce qu'il faut faire : lance /code-review avant chaque commit important (/review marche encore, c'est un alias). La revue tourne dans un subagent qui n'a pas écrit le code : comme un collègue qui relit ton travail, il attrape ce que l'auteur ne voit plus. Monte le niveau (/code-review high) sur ce qui touche à l'auth ou aux paiements, et complète avec /security-review.
Exemple réel : sur Panettone, une review a détecté que des données sensibles étaient loggées en console. Sans la review, ces données auraient été visibles en production.
Erreur 12, changer de modèle ou reprendre une longue session à froid sans le savoir
Ce qui se passe : ta limite fond plus vite que prévu et tu ne comprends pas pourquoi. Claude Code garde en cache le début de ta conversation : prompt système, CLAUDE.md, mémoire, échanges déjà faits.
À chaque message, Claude Code renvoie toute la conversation au modèle. Le cache évite de tout retraiter : si le début de la requête est identique au caractère près à ce que le modèle vient de traiter, ce début est relu pour une fraction du prix (0,20 $ le million de tokens sur Opus 5.5, contre 4 $ sans cache). Un seul changement dans ce début, et tout ce qui suit est retraité au prix fort.
Sur mes sessions, la quasi-totalité de l'input est relue en cache (les chiffres sont au chapitre 19). Deux gestes anodins le cassent :
- Changer de modèle en cours de session. Chaque modèle a son propre cache. Passer d'Opus 5.5 à Sonnet 5.5 sur une conversation de 100 000 tokens pour "économiser" : le tour suivant réécrit tout le cache, environ 0,25 $ au tarif API, au lieu de 0,02 $ pour le relire sur Opus. L'économie ne vient qu'après plusieurs tours. Même effet avec
opusplan(qui bascule entre Opus et Sonnet à l'entrée et à la sortie du plan mode) ou une skill qui impose sonmodel:. - Reprendre une grosse session après une pause. Le cache expire au bout d'1 heure pour la conversation principale sur abonnement, au bout de 5 minutes avec une clé API ou des crédits d'usage. Au retour, le premier message retraite tout.
Ce sont les deux plus fréquents. Il y en a d'autres :
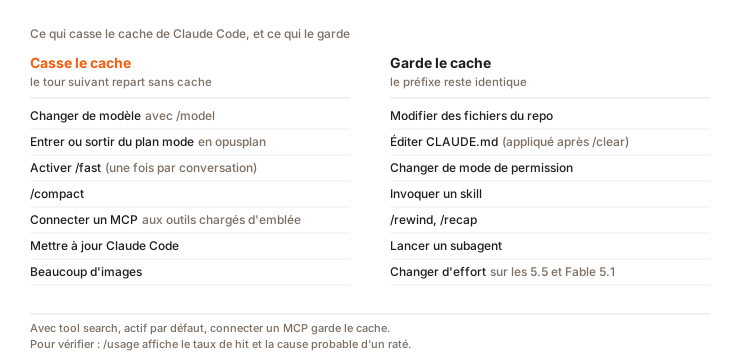
L'ordre de grandeur, au prix API d'Opus 5.5, pour une session de 300 000 tokens : environ 0,06 $ pour la relire en cache. La retraiter à froid coûte environ 1,50 $ avec un cache de 5 minutes et 2,40 $ avec un cache d'1 heure (écrire un cache long coûte plus cher). Chez moi, les reprises à froid sont bien plus fréquentes que les changements de modèle.
Ce qu'il faut faire :
- Choisis ton modèle en début de session et garde-le. Pour une tâche simple, lance un subagent haiku plutôt que de faire basculer toute ta conversation.
- Pour dépenser moins, baisse l'effort avec
/effort: sur les modèles 5.5 et Fable 5.1, ça ne casse pas le cache. - Après une longue pause sur une grosse session,
/clearet un résumé valent mieux qu'une reprise à froid. Sur Pro et Max, Claude Code te propose de repartir d'un résumé : accepte. - Vérifie avec
/usage: la ligne cache affiche le taux de lecture en cache et la cause probable d'un raté.
Signe d'alerte : /usage montre un cache froid alors que tu n'as rien
fait de spécial. Cherche le changement de modèle ou la pause. Le chapitre
19 détaille tout le mécanisme.
Question
Session de 200 000 tokens sur Opus 5.5, abonnement Pro. Tu veux que la suite coûte moins cher. Quel geste garde le cache ?
Choisis une réponse pour voir l'explication.
À retenir
- Les 11 premières erreurs sont classées par impact. Corrige-les dans l'ordre.
- Le
CLAUDE.mdest le plus critique. La gestion du contexte et la review sont les plus sous-estimées. - La 12e vide ta limite en silence. Parade : un modèle par session, et jamais de reprise à froid d'une grosse conversation.
Quiz de fin de partie
Partie 4 : Mettre en pratique
6 questions. La partie est validée à partir de 5 bonnes réponses.