Ce que Claude Code consomme, et comment le réduire sans perdre en qualité : cache, modèle, effort, contexte, suivi de la conso. Les autres chapitres renvoient ici pour le détail.
Pourquoi s'en soucier, même sur abonnement
Un token, c'est l'unité que le modèle lit et écrit : un bout de mot, en gros. Tout se compte en tokens, l'entrée (ce que Claude lit) comme la sortie (ce qu'il écrit).
Sur un abonnement, tu ne paies pas au token. Mais tu as deux limites : une fenêtre de session qui se réinitialise toutes les 5 heures, et une limite hebdomadaire. Les deux sont partagées entre claude.ai, Claude Code, l'app desktop et Claude Design. Anthropic ne publie aucun quota chiffré par plan. Quand tu touches la limite, soit tu attends, soit tu passes sur les crédits d'usage, facturés au tarif API, avec un plafond mensuel que tu fixes (sur Team et Enterprise, c'est un admin qui les active).
Depuis le 7 octobre 2026, Max et Team incluent des crédits API mensuels. Ils couvrent l'API, Managed Agents et l'Agent SDK, mais pas Claude Code.
Les ordres de grandeur officiels, côté entreprise : environ 13 $ par développeur et par jour actif en moyenne (150 à 250 $ par mois), et moins de 30 $ par jour actif pour 90 % des utilisateurs.
Mes chiffres, mesurés au 1er octobre 2026 :
1 255 sessions = 27 964 $ au prix API, pour moins de 2 000 $ d'abonnement. Et une session vide, avant même mon premier message, pèse 63 514 tokens, dont 98,6 % lus en cache.
L'abonnement absorbe beaucoup, mais les limites tombent vite si tu gaspilles : deux heures dans Claude Design m'ont pris la moitié de mon plan Max (chapitre 15).
Comment Claude Code consomme
Le modèle n'a aucune mémoire entre deux messages. À chaque message, Claude Code renvoie tout le paquet depuis le début. Ce paquet, c'est le contexte : tout ce que le modèle a sous les yeux pour répondre. Il est empilé dans cet ordre :
- Le prompt système et les définitions d'outils. Ils bougent rarement.
- Le contexte projet : CLAUDE.md, mémoire automatique, rules.
- La conversation : tes messages, les réponses, chaque fichier lu, chaque sortie de commande.
Ce qui entre dans la conversation y reste jusqu'au prochain /clear ou /compact. Un fichier de 3 000 lignes lu au troisième message est renvoyé à chaque message suivant.
Côté sortie, tout ce que Claude écrit est facturé au tarif sortie, le plus cher. Le raisonnement interne (le thinking) compte aussi comme sortie. Sur les modèles 5.5 et Fable, on ne peut pas le couper. Le levier, c'est l'effort : le niveau de réflexion que tu demandes au modèle avant de répondre (low, medium, high, xhigh, max). Moins d'effort, moins de thinking, moins de sortie.
Le cache, en détail
Le principe
Le cache, c'est la mémoire côté Anthropic du début de ton paquet. Si le début est identique caractère pour caractère à la requête précédente, il est relu à prix cassé au lieu d'être retraité. Le moindre changement en amont fait repasser au prix fort tout ce qui suit.
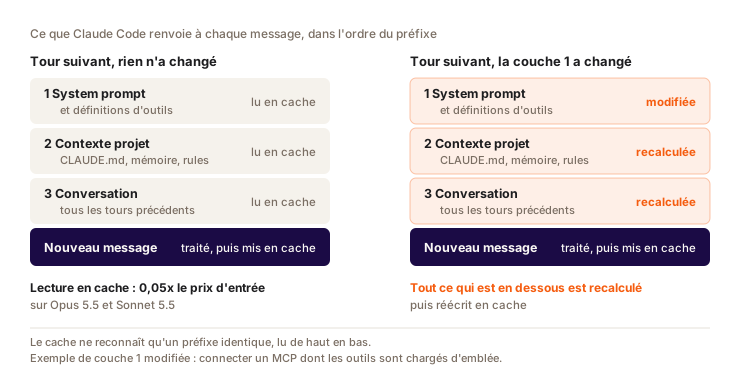
Une session vide est lue à 98,6 % en cache parce que le prompt système et les outils ne changent pas d'un message à l'autre. Pour la même raison, le plan mode et les skills ajoutent leurs consignes en bas, dans la conversation : le préfixe ne bouge pas.
Les prix
Prix par million de tokens, API, octobre 2026 :
| Modèle | Entrée | Écriture cache 5 min | Écriture cache 1 h | Lecture cache | Sortie |
|---|---|---|---|---|---|
| Fable 5.1 | 10 $ | 12,50 $ | 20 $ | 0,25 $ | 50 $ |
| Opus 5.5 | 4 $ | 5 $ | 8 $ | 0,20 $ | 20 $ |
| Sonnet 5.5 | 2 $ | 2,50 $ | 4 $ | 0,10 $ | 10 $ |
| Haiku 5.5 (prompt ≤ 100K) | 0,10 $ | 0,125 $ | 0,20 $ | 0,01 $ | 0,50 $ |
En multiplicateurs, par rapport au prix d'entrée : une lecture en cache coûte 0,05x sur Opus 5.5 et Sonnet 5.5, 0,025x sur Fable 5.1, 0,1x sur les autres. Une écriture coûte 1,25x avec un cache de 5 minutes, 2x avec un cache d'une heure.
Combien de temps il tient (le TTL)
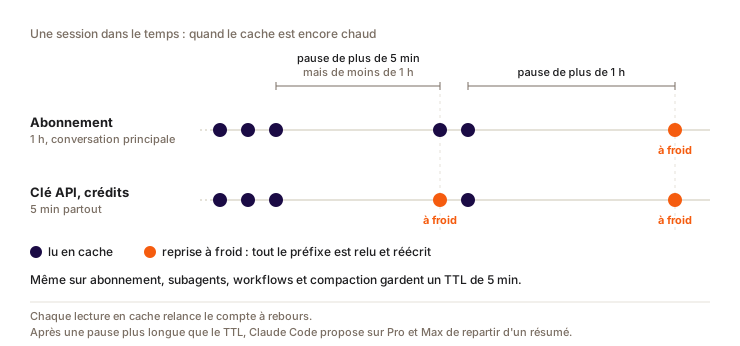
Le temps pendant lequel le cache survit sans activité. Chaque message qui le lit relance le compte à rebours, gratuitement. Passé ce délai, le message suivant repaie tout le paquet. Les durées sont dans le tableau ci-dessous.
| Comment tu paies | Conversation principale | Subagents, workflows, forks, compaction |
|---|---|---|
| Abonnement, dans ton quota | 1 heure | 5 minutes |
| Crédits d'usage, clé API, cloud | 5 minutes | 5 minutes |
Ce qui casse le cache, ce qui le garde
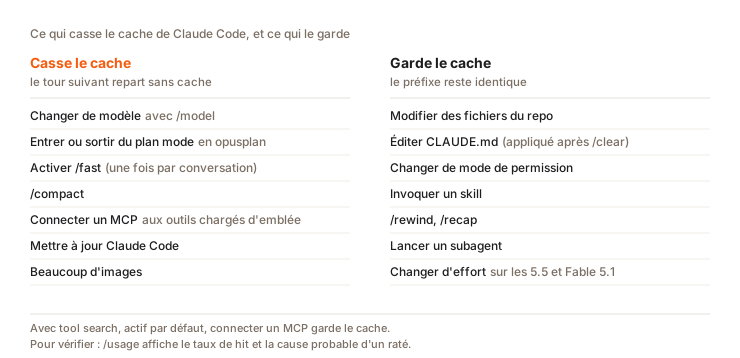
Le tableau reprend la figure, avec quelques cas en plus.
| Casse le cache (le tour suivant repart au prix fort) | Garde le cache |
|---|---|
Changer de modèle avec /model (chaque modèle a son propre cache) | Modifier des fichiers du repo |
opusplan, qui change de modèle en entrant et en sortant du plan mode | Modifier CLAUDE.md en pleine session (la modif s'applique au prochain /clear, /compact ou redémarrage) |
Une skill avec un model différent dans son frontmatter | Changer de mode de permission ou d'output style |
| Changer d'effort, sauf sur Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.1 | Changer d'effort sur Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.1 |
Activer /fast (une fois par conversation) | Invoquer une skill, passer en plan mode |
| Connecter ou retirer un MCP dont les outils sont chargés d'emblée | Connecter un MCP avec le tool search (comportement par défaut) |
/compact | /recap, /rewind, /cd, /fork |
| Beaucoup d'images dans la conversation | Lancer un subagent |
| Mettre à jour Claude Code (le premier tour après la mise à jour repart de zéro) |
L'exception sur l'effort vaut avec une clé API ou un abonnement. Sur Bedrock ou Google Cloud, changer d'effort casse le cache comme avant.
L'équipe Claude Code a raconté sur le blog d'Anthropic, le 30 avril 2026 ("Lessons from building Claude Code: prompt caching is everything"), qu'elle déclare un incident quand le taux de cache chute. Changer de modèle pour "économiser" va souvent dans le mauvais sens. Sur une conversation de 100 000 tokens, passer d'Opus 5.5 à Sonnet 5.5 oblige à réécrire tout le cache sur Sonnet : 0,25 $ (2,50 $/M), contre 0,02 $ pour le relire sur Opus (0,20 $/M). L'économie ne vient qu'après plusieurs tours. Pour une sous-tâche simple, lance plutôt un subagent sur Haiku.
La reprise à froid, chiffrée
Le premier message envoyé après une pause plus longue que le TTL. Le cache a expiré : Claude Code relit toute la conversation sans réduction et la réécrit dans le cache, au prix d'écriture. Le message en lui-même peut faire trois mots, c'est la conversation derrière qui se repaie.
Exemple : une conversation de 300 000 tokens sur Opus 5.5.
- À chaud, la relire coûte 300 000 × 0,20 $ / M = 0,06 $.
- À froid, tout repasse en écriture de cache : 300 000 × 8 $ / M = 2,40 $ avec le cache 1 h, 300 000 × 5 $ / M = 1,50 $ avec le cache 5 min.
Entre 25 et 40 fois plus cher, pour le même message. Le cache 1 h coûte plus cher à l'écriture, mais il évite la reprise à froid quand tu pars déjeuner 40 minutes. Sur crédits ou clé API, avec 5 minutes de TTL, un café suffit à tout refroidir.
Sur 30 jours, j'ai compté 147 reprises à froid et 11 changements de modèle en cours de session. Chacun a fait repayer une conversation entière.
Deux parades :
- Reprendre depuis un résumé. Sur Pro et Max, quand tu reprends une grosse session après une longue pause, Claude Code propose de repartir d'un résumé plutôt que de toute l'histoire.
- Repartir propre. Si la tâche est finie,
/clearet une nouvelle session coûtent moins qu'une reprise à froid de 300 000 tokens.
Vérifier ton TTL
claude -p "réponds juste ok" --output-format json
Dans le JSON, regarde usage.cache_creation. Les écritures en cache 1 h apparaissent sous ephemeral_1h_input_tokens, celles en 5 minutes sous ephemeral_5m_input_tokens.
Régler le TTL toi-même
# 1 h pour la conversation principale (utile sur clé API ou crédits d'usage)
export CLAUDE_CODE_PROMPT_CACHE_TTL=1h

# 1 h partout, conversation et subagents
export ENABLE_PROMPT_CACHING_1H=1

# 5 min partout (pour débugger ou comparer)
export FORCE_PROMPT_CACHING_5M=1
L'équivalent dans settings.json : promptCacheTtl et subagentPromptCacheTtl, avec "5m" ou "1h". Il faut Claude Code v2.1.242 ou plus. Le 1 h se rentabilise si tu fais des pauses de plus de 5 minutes. Sur des rafales courtes, tu paies l'écriture double pour rien.
Choisir le modèle et l'effort
Dans Claude Code, le modèle par défaut est Opus 5.5, sur tous les plans, avec un effort medium. Les quatre modèles actuels (Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5) ont tous 1 million de tokens de contexte.
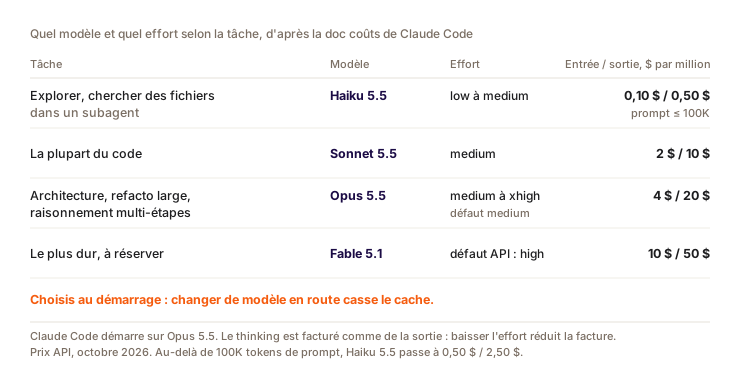
| Tâche | Modèle conseillé | Effort |
|---|---|---|
| La plupart du code : features, bugs, tests | Sonnet 5.5 | medium |
| Architecture, raisonnement en plusieurs étapes, gros refacto | Opus 5.5 | medium, puis high ou xhigh |
| Subagents simples : recherche, lecture de logs, inventaire | Haiku 5.5 | low ou medium |
| Problème très dur où seule la qualité compte | Fable 5.1 | À doser : le plus cher (10 $ / 50 $) |
Le choix de modèle suit la doc coûts de Claude Code. Pour l'effort, pars du défaut et monte seulement si la réponse ne tient pas. Moi je tourne en high sur Opus 5.5, en sachant ce que ça coûte en sortie.
Les commandes :
/model sonnet
/effort medium
claude --model sonnet --effort medium
export CLAUDE_CODE_SUBAGENT_MODEL=haiku
CLAUDE_CODE_SUBAGENT_MODEL fixe le modèle des subagents, des teammates et des agents de workflow qui n'en ont pas d'assigné. Pour un subagent précis, mets model: haiku dans son frontmatter. Le niveau max ne vaut que pour la session en cours, il n'est pas accepté dans les settings.
Décide au démarrage. Le modèle fait partie de la clé du cache. Changer de modèle en cours de route fait repayer toute la conversation. L'effort, lui, se change sans casser le cache sur les modèles 5.5 et Fable 5.1.
Trois réglages changent de modèle sans que tu y penses :
/fastgarde le même modèle et répond environ 2,5 fois plus vite, mais au tarif fast : 8 $ / 40 $ par million sur Opus 5.5, le double du normal. Et l'activer recalcule une fois tout le contexte sans cache. Si tu le veux, active-le en début de session.opusplanutilise Opus en plan mode et Sonnet en exécution. Chaque bascule est un changement de modèle.- Une skill avec
model:dans son frontmatter fait un changement de modèle le temps de son tour.
Garder un contexte léger
/clear, /compact, /rewind : ce que chacun coûte
| Commande | Ce qu'elle fait | Coût |
|---|---|---|
/clear | Repart d'une conversation vide | Gratuit. Remet aussi à zéro le compteur de /usage. Fais un /rename avant pour retrouver la session avec /resume. |
/compact | Relit toute la conversation et la remplace par un résumé | Cache chaud : une fraction du prix. Cache froid : l'opération la plus chère de ta journée. |
/rewind | Revient à un tour précédent (code et conversation) | Moins cher que compacter : tu retombes sur un préfixe déjà en cache. |
/recap | Affiche un résumé de la session sans toucher à l'historique | Garde le cache. |
La règle : compacte quand tu continues la même tâche et que tu manques de place, efface quand tu changes de sujet. Pour orienter le résumé, passe des consignes (/compact garde les décisions sur le schéma de la base) ou ajoute une section "Compact instructions" dans ton CLAUDE.md. Dans /rewind, l'option "Summarize up to here" compacte la conversation jusqu'au point que tu choisis.
L'auto-compact
Sur les modèles à 1 million de tokens, Claude Code compacte tout seul vers 967 000 tokens par défaut. C'est tard, et chaque message à 800 000 tokens se paie. Tu peux avancer le seuil :
/autocompact 500k
/autocompact auto
Le réglage équivalent est autoCompactWindow dans settings.json, entre 100 000 et 1 million.
Ce qui gonfle le contexte, et quoi faire
- CLAUDE.md sous 200 lignes. Il est renvoyé à chaque message. Les workflows spécialisés vont dans des skills, chargées seulement quand elles servent.
- Les skills.
/skill-doctormontre ce que chaque skill coûte en contexte et combien elle sert. Coupe celles qui ne servent pas. - Les MCP. Les outils MCP sont différés par défaut (le tool search) : ils s'annoncent par leur nom et ne pèsent presque rien au repos. Le risque vient de leurs réponses, plafonnées à 25 000 tokens par défaut. Quand une CLI existe (
gh,aws), elle est souvent plus sobre qu'un MCP. Détails au chapitre 17. - Les sorties de commandes. Un hook peut filtrer avant que Claude lise. L'exemple de la doc : un hook
PreToolUsequi réécrit la commande de tests pour ne garder que les échecs. Un log de 10 000 lignes devient quelques centaines de tokens. - Les captures d'écran. Colle le texte de l'erreur plutôt qu'une image. Beaucoup d'images cassent aussi le cache.
- Les sorties verbeuses. Délègue à un subagent : lancer la suite de tests, lire des logs, fouiller la doc. Sa sortie reste dans son contexte, seul un résumé revient. Attention, un subagent ne lit pas ton cache et n'a que 5 minutes de TTL, même sur abonnement. Un fork part au contraire du cache de la conversation : le subagent forké de
/subtask, comme la copie de session de/fork. - Les prompts vagues. "Regarde le projet et améliore les perfs" fait lire la moitié du repo. Dis où chercher. Et si Claude part dans la mauvaise direction,
Esctout de suite : chaque tour inutile se paie.
Les outils tiers
| Outil | Ce qu'il fait | Ce qui est mesuré |
|---|---|---|
| Caveman | Fait répondre Claude en style télégraphique | Le repo annonce -65 % de sortie. Chiffre non mesuré de façon indépendante. La sortie n'est qu'une partie de la facture. |
| RTK | Filtre les sorties d'outils avant que Claude les lise | Il filtre 74 % du texte des sorties d'outils (chiffre auto-déclaré). Un test A/B de JetBrains ne montre pas de gain net. |
| ccusage | Lit les logs JSONL locaux de Claude Code et chiffre ta conso | Open source, pratique (ccusage blocks --live). C'est une estimation au prix API, pas ta facture d'abonnement. |
Avant d'installer un outil, note ta conso dans /usage, puis compare une semaine après.
Suivre ta conso
| Commande ou outil | Ce qu'il montre |
|---|---|
/usage | Coût estimé, limites du plan, et sur abonnement la répartition par skill, subagent, plugin et serveur MCP. Alias : /cost, /stats. |
/context | Ce qui occupe la fenêtre maintenant, en grille, avec des suggestions. /context all pour le détail. |
/insights | Un rapport HTML sur ta façon de travailler (points de friction, suggestions). Il consomme lui-même des tokens. |
| La status line | Tes chiffres en permanence sous le champ de saisie. |
| OpenTelemetry | Pour une équipe : tokens, coûts et activité par personne, exportés vers ta propre stack d'observabilité. |
Dans /usage, la ligne Prompt cache (main) donne ton taux de hit, indique si le cache est chaud ou froid, et nomme la cause probable du dernier miss (par exemple, des définitions d'outils qui ont changé). Regarde-la après chaque session qui t'a paru chère.
Une status line qui affiche le coût, la limite des 5 heures et l'état du cache :
#!/bin/bash
input=$(cat)

COST=$(echo "$input" | jq -r '.cost.total_cost_usd // 0')
FIVE_H=$(echo "$input" | jq -r '.rate_limits.five_hour.used_percentage // "?"')
HIT=$(echo "$input" | jq -r '.prompt_cache.hit_ratio // 0')
WARM=$(echo "$input" | jq -r 'if .prompt_cache.warm then "chaud" else "froid" end')

echo "\$$COST | 5h: ${FIVE_H}% | cache ${WARM} (hit ${HIT})"
rate_limits n'apparaît que sur Pro et Max, après la première réponse. cost.total_cost_usd est une estimation au prix catalogue, pas ta facture. Le branchement de la status line est montré dans ma configuration.
Depuis le 1er octobre 2026, un mod (du code qui tourne dans Claude Code) peut aussi te montrer ces chiffres. Tout ce qu'il fait sans appeler de modèle, comme une commande qu'il sert ou une ligne sous le prompt, ne lance aucun tour de Claude et ne coûte aucun token. Le chapitre 20 en construit un en 39 lignes : il affiche le remplissage du contexte, la part du dernier tour lue en cache et le temps qu'il reste avant que le cache refroidisse, pour voir venir la reprise à froid. Ce qui coûte, en revanche, c'est un mod qui appelle un modèle ($.model.complete) ou soumet un prompt : lis la ligne calls: de claude plugin validate avant d'en installer un.
Quand tu touches une limite, /usage-credits ouvre les réglages des crédits d'usage. /rate-limit-options propose aussi d'attendre la réinitialisation de la fenêtre et de reprendre la tâche automatiquement.
Le plan d'action : 10 réflexes
Classés par ordre de gain probable, du plus rentable au plus marginal.
- Choisis le modèle au démarrage et n'en change plus. Sonnet 5.5 pour le code courant, Opus 5.5 quand ça demande du raisonnement.
- Évite les reprises à froid. Après une longue pause, reprends depuis un résumé ou
/clear. /clearà chaque changement de sujet, après un/rename.- Baisse l'effort sur les tâches simples. Sur les 5.5, ça ne casse pas le cache.
- Délègue le verbeux à un subagent sur Haiku 5.5 : tests, logs, exploration.
- Dis à Claude où chercher plutôt que de le laisser fouiller le repo.
- Garde ton CLAUDE.md sous 200 lignes et passe le reste en skills.
- Filtre les sorties avec un hook (ne garder que les tests en échec).
- Colle du texte, pas des captures.
- Regarde
/usageune fois par semaine, en particulier la ligne cache et la répartition par skill et par MCP.
Mesurer en euros et en CO2
/usage donne ta conso de la session et de la semaine. Pour un coût en euros sur un mois, ou un équivalent carbone, il faut un autre outil.
Je voulais voir mes sessions en euros et en CO2, pas seulement en pourcentage de limite. J'ai donc écrit claude-carbon, le plugin présenté au chapitre 16, puis TokenClimate pour faire le même calcul sur l'usage IA d'une équipe. Pour un ordre de grandeur sans rien installer, il y a le calculateur, et ce guide reprend les leviers de ce chapitre côté facture.
Question
Lequel de ces gestes fait repartir le tour suivant sans cache ?
Choisis une réponse pour voir l'explication.
Question
Abonnement Max, Opus 5.5, conversation de 300 000 tokens. Tu passes de /effort high à /effort low. Que devient le cache ?
Choisis une réponse pour voir l'explication.
À retenir
- À chaque message, Claude Code renvoie tout. Le cache rend ça supportable, à condition que le début du paquet ne bouge pas.
- Changer de modèle ou reprendre une session refroidie fait repayer toute la conversation : jusqu'à 40 fois le prix d'un message à chaud sur 300 000 tokens.
- Sonnet 5.5 pour la plupart du code, Opus 5.5 pour le raisonnement, Haiku 5.5 pour les subagents. L'effort se baisse sans casser le cache sur les 5.5.
/clearest gratuit./compactsur un cache froid est l'opération la plus chère.- Mesure avant d'optimiser :
/usage, la lignePrompt cache (main), puis claude-carbon ou TokenClimate pour le coût estimé et le CO2.
Sources
- Track and reduce costs (doc Claude Code)
- How Claude Code uses prompt caching (doc Claude Code) et Lessons from building Claude Code: prompt caching is everything (blog, 30 avril 2026)
- Pricing et Prompt caching (doc Claude Platform)
- Model configuration (doc Claude Code)
- Understanding usage and length limits (centre d'aide)
Mes outils et mesures : claude-carbon, TokenClimate, ce que coûte Claude Code, le coût d'un contexte long (cours gratuit), et la fiche « Claude Code sans gaspiller » (deux mois, 230 sessions mesurées).